Почему риски ИИ различаются по отделам
Когда руководитель компании запрещает ИИ или, наоборот, разрешает его везде без ограничений, он принимает решение, не учитывая реальную структуру бизнеса. Каждый отдел работает с разными данными, решает разные задачи и имеет разный уровень готовности к технологическим изменениям. Риск утечки данных в отделе маркетинга отличается от риска в бухгалтерии. Скорость внедрения и способность контролировать процесс тоже различаются.
Понимание этих различий — первый шаг к грамотному управлению ИИ в организации. Без этого вы либо сдерживаете развитие, либо теряете контроль над данными.
Данные как ключевой фактор различия рисков
В отделе маркетинга сотрудники работают в основном с открытыми и неконфиденциальными данными: информацией о рынке, конкурентах, публичные кейсы. Здесь риск утечки данных минимален. Если текст, написанный с помощью нейросети, попадёт в публичный домен, компания скорее всего не потеряет ничего.
В финансовом отделе всё иначе. Там циркулируют реальные цифры доходов, затрат, структура расходов, данные о кредитных линиях, информация о контрагентах. Попадание этих данных в чат-боты, обученные на данных интернета, создаст длительное конкурентное преимущество для тех, кто получит доступ к этой информации.
В отделе персонала есть персональные данные сотрудников: зарплаты, оценки, медицинские сведения, информация о дисциплинарных взысканиях. Это не просто коммерческая тайна — это часто защищено законом.
В отделе разработки и IT находятся архитектурные решения, исходный код, информация о уязвимостях. Это может быть использовано конкурентами или киберпреступниками напрямую.
Одинаковый подход к этим отделам невозможен. Первый требует большей свободы, последние требуют гораздо более строгого контроля.
Готовность команды и скорость принятия изменений
Даже в одной компании разные отделы по-разному готовы к работе с ИИ. Молодой отдел маркетинга может уже использовать нейросети в своей работе и понимать их возможности и ограничения. Отдел, где большинство работников в возрасте 50+, может воспринимать ИИ с настороженностью, не понимать его природу и переживать, что инструмент может заменить людей.
Это влияет не только на скорость внедрения, но и на риск человеческой ошибки. Если человек не понимает, какие данные можно передавать в ИИ-сервис, он может скопировать туда всё подряд. Если он боится инструмента, он может саботировать его использование втайне, создавая ещё больший риск.
Для некоторых отделов полезнее будет не запрет, а обучение. Для других — сначала техническое ограничение, потом образование.
Характер задач и возможность проверки
Когда копирайтер использует ИИ для написания черновика статьи, результат легко проверить — можно прочитать текст и понять, подходит ли он. Человеческий глаз за несколько минут выявит галлюцинации, неточности, несоответствия фирменному стилю.
Когда ИИ анализирует финансовые данные и выдаёт рекомендацию по инвестиции, проверить результат может только специалист с глубокими знаниями. Проверка занимает столько же времени, сколько если бы он делал это сам. Здесь использование ИИ может только усложнить процесс, если не будет серьёзного контроля.
Задачи классификации и категоризации (например, отнесение документов к нужным папкам) легче проверяются выборочно. Творческие задачи требуют полной проверки. Аналитические задачи требуют экспертной проверки.
Контроль ИИ — это не вопрос технологии. Это вопрос о том, какие бизнес-процессы вы готовы трансформировать и на какие данные вы готовы дать доступ.
Составьте схему рабочих процессов перед выбором контроля
Прежде чем устанавливать техническое решение для контроля ИИ, нужно понять, как именно сотрудники могут использовать ИИ в своей работе. Это не требует глубокого анализа — достаточно одного дня беседы с руководителями отделов.
Что нужно выяснить о каждом процессе
Для каждого рабочего процесса, где может быть использован ИИ, ответьте на четыре вопроса.
- Какие данные используются. Открытые? Внутренние? Конфиденциальные? Персональные? Коммерческая тайна? Это определит основной риск.
- Куда уходят результаты. Остаются внутри компании? Отправляются клиентам? Публикуются? Передаются третьим лицам? От этого зависит, как критичны ошибки ИИ.
- Кто проверяет результат. Специалист? Конечный пользователь? Система автоматически? От этого зависит, нужен ли вам полный контроль или выборочный.
- Как часто это происходит. Один раз в квартал? Каждый день? Тысячи раз в секунду? От этого зависит, нужна ли вам автоматизация контроля.
Пример для отдела маркетинга: копирайтер пишет статьи для блога. Используются открытые данные о трендах и коммерческие данные о продуктах компании. Результат публикуется на сайте. Проверку делает редактор. Это происходит два-три раза в неделю. Вывод: ИИ можно использовать свободно, контроль через человека, данные о продуктах должны быть обезличены или заменены на примеры.
Пример для отдела финансов: бухгалтер вводит платежи в систему. Используются конфиденциальные данные о контрагентах, сумме и реквизитах. Результат влияет на отчётность и кассу компании. Проверку делает главный бухгалтер. Это происходит десятки раз в день. Вывод: ИИ может помочь только в ручной обработке документов, но не должен иметь доступ к реальным данным. Нужен виртуальный тренировочный окружение.
Как визуализировать схему процессов
Не нужен сложный диаграмма. Просто напишите в таблице или текстовом документе для каждого отдела:
- Процесс (название)
- Входные данные (что используется)
- ИИ-помощь (что конкретно может сделать ИИ)
- Выходные данные (что получается)
- Проверка (кто и как проверяет)
- Риск утечки данных (низкий, средний, высокий)
Это займёт пару часов работы, но даст вам полную картину. На её основе вы сможете разработать политику, которая не будет ни слишком строгой, ни слишком мягкой.
Большинство проблем с использованием ИИ в компаниях возникают потому, что управление начинается без понимания того, что именно нужно управлять. Контроль без схемы процессов — это либо запрет, либо хаос.
Контролируйте передачу данных, а не только промпты
Когда говорят о контроле ИИ, часто думают о том, чтобы запретить сотрудникам использовать ChatGPT или другие сервисы. Это поверхностный подход. На самом деле главный риск — это не сам факт использования ИИ, а то, какие данные попадают в эти системы.
Сотрудник может использовать ИИ очень безопасно, если понимает, какие данные можно туда загружать. И может нанести огромный ущерб, даже если технически ему запретили использовать ИИ — просто потому что он начнёт использовать его втайне и будет менее ответственным.
Три точки передачи данных, на которые нужно смотреть
Данные попадают в внешние ИИ-сервисы в трёх основных точках.
Первая точка: прямая загрузка в чат. Сотрудник открывает ChatGPT, копирует туда текст письма клиента, контрольные цифры проекта или текст договора — и просит ИИ помочь. Это самый очевидный и контролируемый способ утечки данных, потому что понятно, что произойдёт.
Вторая точка: API-интеграции. Когда компания подключает ИИ-сервис через API в свои системы (например, интегрирует нейросеть в CRM), данные идут на серверы внешнего сервиса автоматически. Процесс менее заметен, но может быть намного масштабнее. Если в CRM находится история переговоров с клиентами, информация о сделках, детали контрактов — всё это потенциально может быть обработано внешним ИИ.
Третья точка: косвенная передача через описание проблемы. Сотрудник не загружает данные напрямую, но описывает их в промпте так подробно, что ИИ получает полную информацию о ситуации. Например, он может сказать: "У меня есть клиент ООО "Рога и копыта", который заказал партию из 5000 единиц продукции X по цене 250 рублей за единицу, оплата по счёту 123456, контактное лицо Иван Петров, телефон 8-900-123-45-67. Как мне лучше всего организовать доставку?" В этом случае ИИ получил чувствительную информацию без загрузки файлов.
Категоризация данных перед контролем
Прежде чем решать, как контролировать передачу данных, классифицируйте данные вашей компании по уровню конфиденциальности. Это поможет понять, что именно нужно защищать.
- Открытые данные. Информация, которая уже публична или легко доступна конкурентам. Например, информация о рынке из открытых отчётов, стандартные бизнес-практики, публичные документы. Такие данные могут свободно передаваться в ИИ-сервисы.
- Внутренние данные. Информация, которая нужна для работы, но её утечка не будет критична. Например, внутренние инструкции, общие принципы организации работы, неконкретные примеры процессов. Такие данные можно передавать в обезличенном виде.
- Конфиденциальные данные. Информация, которая дает прямое конкурентное преимущество или является коммерческой тайной. Это конкретные цены, объёмы продаж, информация о поставщиках, детали договоров с клиентами, структура затрат. Такие данные передавать нельзя.
- Защищённые данные. Информация, которая защищена законом. Персональные данные сотрудников, данные о клиентах (если это требуется законом), медицинская информация, информация о судебных разбирательствах. Передача таких данных может привести к штрафам и репутационному ущербу.
Для каждого уровня нужны разные правила.
Практические ограничения для каждого уровня данных
Когда вы поняли, какие данные какого уровня циркулируют в каждом отделе, вы можете установить практические правила.
Для открытых данных правил почти нет. Сотрудник может использовать их в ИИ свободно. Максимум — убедиться, что он не случайно перепутает открытые данные с конфиденциальными.
Для внутренних данных нужно правило обезличивания. Если сотрудник хочет помощь ИИ в обработке информации, он должен удалить из неё специфичные детали. Вместо "наш клиент ООО Рога и копыта" — просто "клиент". Вместо "цена 250 рублей" — "типичная цена для этого сегмента". Когда ИИ даст ответ, сотрудник сможет адаптировать его к своему случаю.
Для конфиденциальных данных — запрет на передачу в любом виде. Но это не значит, что ИИ нельзя использовать вообще. Можно использовать его для помощи в методах и подходах. Например, вместо того чтобы сказать ИИ: "Как мне убедить клиента ООО Рога и копыта заключить контракт на 5 млн рублей?", можно сказать: "Как мне убедить клиента из сегмента производства заключить контракт большого объёма?" Ответ ИИ всё ещё будет полезен, но конфиденциальность сохранится.
Для защищённых данных — абсолютный запрет. Любое использование может привести к юридическим проблемам. Это должно быть зафиксировано в политике и технически усилено, если это возможно.
На этом этапе вы можете провести простой аудит. Пройти по каждому отделу, спросить руководителя: "Какие данные ты отправляешь или можешь отправить в ИИ?" и классифицировать их по уровням. На основе этого вы сможете написать конкретные правила, которые люди действительно смогут соблюдать.
Уровни доступа вместо единого запрета для всех
После того как вы поняли, какие данные какого уровня есть в каждом отделе, нужно перейти от теории к практике. Это значит: установить разные уровни доступа к ИИ для разных групп сотрудников. Единый запрет для всех или единое разрешение для всех — оба подхода создают проблемы.
Запрет вызывает теневое использование. Сотрудники начинают использовать ИИ втайне, потому что они видят, что инструмент помогает их работе. Когда использование скрыто, компания вообще не может контролировать, какие данные попадают в нейросети. Это опаснее, чем открытое использование с понятными правилами.
Полное разрешение без правил приводит к утечкам данных. Люди не злые и не хотят навредить компании, но они часто не понимают, какие данные чувствительны. Они копируют в чат всё подряд, потому что это быстро и легко.
Решение — многоуровневый доступ. Разным отделам, разным должностям, разным типам данных — разные правила.
Как структурировать уровни доступа
Можно использовать простую систему из четырёх уровней. Она работает для большинства компаний, от 20 сотрудников до нескольких тысяч.
Уровень 1: Без доступа. Сотрудник не может использовать ИИ вообще. Это касается людей, которые работают с защищёнными данными, которые по закону нельзя передавать куда-либо. Например, если вы работаете с государственными тайнами или медицинской информацией, подлежащей защите по закону, ИИ использовать нельзя.
Уровень 2: Только без загрузки данных. Сотрудник может использовать ИИ, но не может загружать файлы, документы, таблицы. Может только писать текстовые запросы. Это касается людей, которые работают с конфиденциальными данными, но могут формулировать запросы так, чтобы не упоминать специфичные детали. Например, менеджер по продажам может спросить у ИИ: "Как мне структурировать презентацию для крупного клиента?" вместо того чтобы загружать реальный контракт.
Уровень 3: С загрузкой обезличенных данных. Сотрудник может загружать данные, но только после удаления конкретной информации. Например, копирайтер может загрузить текст статьи, но только если заменит названия реальных клиентов на обезличенные примеры. Это полезно для отделов, которые часто нуждаются в помощи ИИ, но должны защищать коммерческую информацию.
Уровень 4: Полный доступ. Сотрудник может использовать ИИ, загружать любые данные, подключать сервисы. Это касается людей, которые работают с открытой информацией или у которых нет доступа к чувствительным данным. Например, junior-специалист в маркетинге, который только пишет черновики статей, может иметь полный доступ.
Система простая, но требует честности. Нужно честно оценить, с какими данными работает каждый сотрудник. Это можно сделать на беседе с руководителем отдела: "Что делает этот сотрудник? Какие данные он видит каждый день? Есть ли у него доступ к информации, которую нельзя передавать третьим лицам?"
Как применять уровни в разных отделах
Давайте посмотрим, как это может выглядеть на практике в разных отделах.
В отделе маркетинга: junior-копирайтер (уровень 4), senior-копирайтер (уровень 3), менеджер по продуктам (уровень 2), руководитель отдела (уровень 2 или 3 — зависит от того, какую информацию ему нужно обсуждать с ИИ).
В отделе продаж: junior-менеджер (уровень 2 или 3), senior-менеджер (уровень 2), руководитель отдела (уровень 1 или 2 — потому что они работают с реальными коммерческими предложениями и нюансами договоров).
В отделе разработки: intern (уровень 4, но только если не имеет доступа к production-коду), junior-разработчик (уровень 2), senior-разработчик (уровень 2), архитектор (уровень 1 или 2).
В бухгалтерии: все (уровень 1 или уровень 2 для очень специфичных задач — и то в исключительных случаях).
В отделе HR: специалист по набору (уровень 3 или 4), специалист по развитию (уровень 2), специалист по компенсациям (уровень 1), руководитель отдела (уровень 1 или 2).
Правильный уровень доступа — это не максимум безопасности, а баланс между безопасностью и полезностью. Если уровень слишком строгий, люди начнут обходить его. Если слишком мягкий, появятся утечки данных.
Три сценария управления доступом к ИИ
Система уровней доступа — это абстракция. На практике есть три основных сценария, которые компании выбирают для управления ИИ. Каждый имеет свои преимущества и недостатки.
Сценарий 1: Полный запрет доступа
Компания запрещает использование ChatGPT, Claude, Gemini и других ИИ-сервисов полностью. На техническом уровне это может быть реализовано через блокировку доменов на уровне DNS или файрволла, через политику безопасности в операционных системах сотрудников, через ограничение в корпоративной сети.
Преимущества этого подхода ясны: максимальная безопасность данных, нет риска утечки информации через ИИ-сервисы, полный контроль над информационными потоками.
Недостатки становятся видны очень быстро. Во-первых, такой запрет замораживает развитие. Конкуренты используют ИИ, их сотрудники работают быстрее, создают больше вариантов, экспериментируют. Ваша компания отстаёт. Во-вторых, сотрудники начинают использовать личные аккаунты. Они приходят домой, в кафе, берут свои телефоны и работают с ИИ. Теперь компания вообще не видит, какие данные они передают. Это ещё опаснее, чем контролируемое использование в офисе. В-третьих, молодые таланты не хотят работать в компаниях, где запрещены стандартные инструменты. Они уходят в конкурирующие компании.
Полный запрет может работать только в отраслях с максимальными требованиями к безопасности: оборона, государственный сектор, некоторые части финансового сектора. И то — только если компания готова проверять соответствие правилам постоянно и строго наказывать нарушения.
Сценарий 2: Работа с ИИ без загрузки файлов
Компания разрешает использовать ИИ, но запрещает загружать файлы, документы, таблицы. Сотрудник может только писать текстовые запросы. Это промежуточное решение между запретом и полной свободой.
На техническом уровне это реализуется через ограничение функционала в самом приложении (если компания использует корпоративную версию) или через правила политики безопасности ("You must not upload files to external AI services").
Преимущества: сотрудники получают доступ к ИИ, что повышает их производительность. Основные чувствительные данные (которые обычно хранятся в файлах — контракты, финансовые отчёты, персональные данные) защищены. Сотрудники всё ещё могут использовать ИИ для помощи в рассуждениях, структурировании информации, генерации идей.
Недостатки: некоторые задачи становятся очень неудобными. Если нужно помочь ИИ проанализировать таблицу с сотней строк, нельзя просто загрузить файл. Нужно копировать данные вручную, что медленнее и чаще вызывает ошибки. Сотрудник может "забыть" правило и загрузить файл из личного аккаунта. Контроль становится зависимым от добросовестности людей, а не от техники.
Этот сценарий подходит для компаний, которые хотят использовать ИИ, но чувствительны к рискам утечки данных. Например, компании в финтехе, консалтинге, правовом сегменте.
Сценарий 3: Доступ к ИИ без передачи конфиденциальных данных
Компания разрешает использовать ИИ максимально, но с явным правилом: конфиденциальные данные туда не передавать. Сотрудник может загружать файлы, писать запросы, интегрировать ИИ в системы — но должен убедиться, что чувствительная информация удалена.
На техническом уровне контролировать это сложнее. Нужны инструменты для мониторинга трафика, проверки загруженных файлов, обучение сотрудников. Но если организовать правильно, это работает.
Преимущества: максимальная гибкость и производительность. Сотрудники могут использовать ИИ так, как им нужно. Компания получает полный выигрыш от внедрения технологии.
Недостатки: требует постоянного контроля, обучения, культуры ответственности. Если в компании нет этой культуры, начнутся утечки. Нужны инструменты для мониторинга, что требует инвестиций и IT-ресурсов.
Этот сценарий подходит для компаний, которые готовы инвестировать в правильное внедрение ИИ. Например, tech-компании, где люди уже привыкли работать с инструментами и понимают риски.
Как выбрать сценарий для вашей компании
Выбор зависит от трёх факторов: отрасль, культура компании, есть ли ресурсы для мониторинга.
Если вы в банке или государственном учреждении — сценарий 1 или 2. Если вы в консалтинге или правовом агентстве — сценарий 2 или 3. Если вы в tech-компании или стартапе — сценарий 3.
Если в компании сильная IT-команда и есть системы мониторинга — можно выбрать сценарий 3. Если IT-ресурсов мало — лучше 1 или 2.
Если у вас уже есть культура безопасности и люди понимают важность защиты данных — сценарий 3. Если люди часто нарушают правила безопасности или не очень понимают их смысл — лучше выбрать 1 или 2.
Сценарий — это не навсегда. Большинство компаний начинают с запрета (сценарий 1), потом переходят на сценарий 2, и постепенно, когда появляются ресурсы и опыт, переходят на сценарий 3. Это нормальный путь. Не нужно пытаться внедрить сценарий 3 сразу, если компания к этому не готова.
Технические способы контроля нейросетей
Теперь, когда вы выбрали сценарий, нужно его технически реализовать. Есть несколько способов контроля, которые работают на разных уровнях: от фильтрации на уровне сети до мониторинга поведения сотрудников.
Мониторинг OAuth-авторизаций
Когда сотрудник входит в ChatGPT или другой ИИ-сервис через корпоративный Google-аккаунт или Microsoft-аккаунт, он использует OAuth-авторизацию. Компания может видеть эти попытки входа через логи в Google Workspace или Microsoft Entra ID.
Это не полный контроль, но это начало. Вы можете видеть, кто и когда пытался войти в ИИ-сервис. Можете установить политику, которая блокирует вход или требует дополнительного подтверждения (двухфакторная аутентификация, одобрение администратором).
Преимущества: информация уже есть в ваших системах Google или Microsoft, не нужно покупать дополнительные инструменты. Контроль происходит на уровне аутентификации, то есть до того как человек вообще попал в сервис.
Недостатки: люди могут использовать личные аккаунты и избежать этого контроля. Если человек уже вошёл, вы не видите, что он делает внутри сервиса (какие данные загружает, что спрашивает).
Как реализовать: зайти в Google Workspace Admin Console или Microsoft Entra ID, найти раздел Security или Conditional Access, установить политику для блокировки или требования подтверждения для доменов ИИ-сервисов (openai.com, claude.ai, gemini.google.com и т.д.).
Блокировка загрузки файлов в ИИ-сервисы
Если вы выбрали сценарий 2 (запрет на загрузку файлов), нужны инструменты, которые будут блокировать попытки загрузить файлы на серверы ИИ-сервисов. Это работает на уровне сетевого трафика.
Это можно сделать несколькими способами. Первый — через DLP (Data Loss Prevention) системы, которые проверяют трафик и блокируют определённые типы файлов или данные, которые выглядят чувствительными. Второй — через DNS-фильтры, которые блокируют доступ к определённым хостам (например, openai.com/api/v1/files). Третий — через endpoint-защиту, которая блокирует загрузку на уровне устройства.
Преимущества: работает автоматически, не требует от сотрудников дополнительных действий. Даже если человек забыл о правиле, система всё равно предотвратит утечку.
Недостатки: может быть сложна в настройке и может вызвать ложные срабатывания. Например, если вы блокируете все PDF-файлы, может быть заблокирован и легальный PDF, который не содержит чувствительных данных. Требует инвестиций в инструменты (DLP-системы обычно дорогие). Люди, которые используют личные сети (например, мобильный интернет), могут её обойти.
Как реализовать: нужны специальные системы, такие как Zscaler, Fortinet FortiGate, Palo Alto Networks Prisma Access или встроенные возможности Microsoft Defender для Endpoint. Обычно это консультация с IT-специалистом, потому что нужна правильная настройка.
Анализ сетевого трафика
Более продвинутый способ — анализировать весь трафик, который идёт из корпоративной сети в ИИ-сервисы. Это даёт видимость того, кто, когда и как использует ИИ.
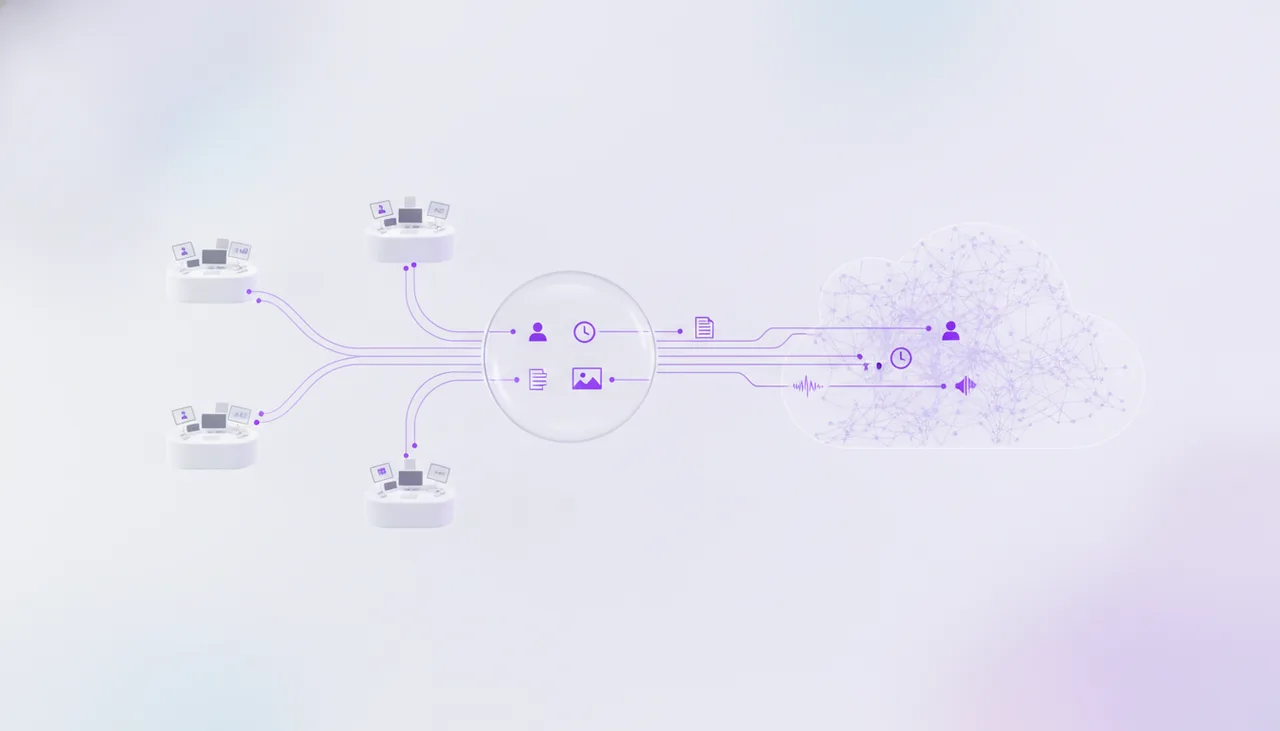
Система анализирует потоки трафика, может определить, загружается ли большой файл, какой тип данных передаётся, как часто. Можно установить пороги — например, если за 5 минут загружено более 10 МБ данных, система должна отправить алерт администратору.
Преимущества: видимость. Вы знаете, что происходит. Можете выявить проблемы до того, как они станут серьёзными. Можете обучить сотрудников на примере: "Смотри, твой коллега загрузил файл с рядом данных, это может быть проблема".
Недостатки: требует постоянного мониторинга. Кто-то должен смотреть логи, анализировать их, реагировать на алерты. Это добавляет нагрузку на IT-команду. Может быть воспринято сотрудниками как слежка.
Как реализовать: используя встроенные системы мониторинга в Firewall (например, Palo Alto Networks, Fortinet) или через SIEM-системы (Splunk, Elastic Stack), которые агрегируют логи с разных источников.
Важный момент: если вы решите анализировать трафик, нужно это сообщить сотрудникам. Скрытый мониторинг может быть противозаконен в некоторых юрисдикциях и точно создаст проблемы с доверием, когда люди его обнаружат (а они обнаружат).
Определите ответственность в точках передачи результатов
Когда ИИ используется в процессе, результат должен куда-то попасть. Он может пойти клиенту, он может быть внедрён в систему, он может стать основой для решения. В каждой точке передачи результата нужно ясно определить, кто за него отвечает.
Это часто забывают, и потом начинаются проблемы. Если текст, написанный с помощью ИИ, содержит ошибку и попадает клиенту, кто виноват? Копирайтер, который не проверил? Менеджер, который не пересмотрел? ИИ-система? Компания в целом? Без ясной ответственности каждый ждёт, что другой проверит, и в результате никто не проверяет.
Модель ответственности для разных сценариев
Есть несколько общих моделей, которые работают.
Модель 1: Ответственность остаётся у человека. ИИ — это инструмент. Человек использует его и отвечает за результат. Если копирайтер использует ИИ для черновика статьи, проверяет текст и отправляет его, он отвечает за качество. Это работает для творческих и аналитических задач, где человек может полностью проверить результат.
Модель 2: Ответственность распределена. Несколько человек отвечают за разные части процесса. Например, в медицине врач использует ИИ для анализа снимка, но диагноз ставит сам. ИИ-система отвечает за качество анализа, врач — за финальное решение. Это работает для систем, где есть несколько контрольных точек.
Модель 3: Ответственность у системы. Если процесс полностью автоматизирован и ИИ работает без человеческого вмешательства, ответственность переходит на компанию и на саму систему. Например, если автоматическая система маршрутизирует письма в папки на основе ИИ, компания отвечает за то, что письма идут куда нужно. Это работает только для задач низкого риска, где ошибки не критичны.
Для каждого процесса, который вы описали в схеме рабочих процессов, нужно выбрать модель и зафиксировать её.
Примеры распределения ответственности
Маркетолог использует ИИ для генерации идей для рекламной кампании. Ответственность у маркетолога. Он выбирает идеи, которые использует, и отвечает за результаты кампании.
Система ИИ автоматически распределяет входящие заявки от клиентов между менеджерами. Ответственность у компании. Если заявка попадёт не туда, компания должна это исправить и объяснить клиенту.
Финансовый аналитик использует ИИ для прогноза доходов компании. Ответственность распределена: аналитик отвечает за качество входных данных и проверку результата, ИИ-система отвечает за качество алгоритма.
Бухгалтер использует ИИ для классификации расходов. Ответственность у бухгалтера. Даже если ИИ выдал неправильную классификацию, именно бухгалтер должен был это заметить.
Это может быть табличка в вашей политике или в процессном документе. Главное — чтобы люди знали, на ком лежит ответственность.
Оценивайте риски на последующих этапах, а не только производительность
Компании часто измеряют успех внедрения ИИ только по производительности: сколько работы выполнено быстрее, сколько времени сэкономлено, на сколько процентов упал объём ручной работы. Это ошибка.
Да, производительность важна. Но равно важно измерять риски на последующих этапах. Например, если ИИ генерирует текст быстрее, но качество текста упал на 10%, это может привести к потере клиентов. Если ИИ классифицирует документы быстрее, но ошибки начинают накапливаться, это может привести к неправильным решениям по бизнесу.
Какие риски измерять
Определите для каждого процесса, какие риски есть на последующих этапах, и установите метрики для их измерения.
- Ошибки в результатах ИИ. Сколько ошибок находит человек при проверке результата? Какой процент результатов ИИ требует правки? Если было 5%, а стало 15%, это признак проблемы.
- Качество финальной работы. Если маркетолог использует ИИ для написания статей, измеряйте не только скорость написания, но и количество комментариев читателей, уровень engagement, количество ошибок, которые находят читатели после публикации.
- Потери от неправильных решений. Если финансовый аналитик использует ИИ для прогноза, измеряйте, насколько точным оказался прогноз. Если спрогнозировал убыток в 1 млн, а компания получила прибыль 2 млн, ошибка была серьёзной.
- Риск утечки данных. Как часто сотрудники пытаются загружать чувствительные данные? Как часто это предотвращается? Сколько было фактических утечек?
- Соответствие регуляторным требованиям. Если ваша отрасль требует, чтобы каждое решение было объяснимо, может ли ИИ это обеспечить? Проходит ли использование ИИ аудиты?
Это не означает, что нужно постоянно всё проверять. Достаточно выборочной проверки. Например, проверить 10% результатов ИИ каждый месяц. Если ошибок не обнаружено, можно сократить до 5%. Если ошибок много, увеличить до 50%.
Внедрение политики работы с ИИ
Теперь, когда вы определили уровни доступа, выбрали сценарий, знаете, как контролировать, и распределили ответственность, нужно все это зафиксировать в политике. Политика — это документ, который говорит людям: вот какие правила у нас есть, вот почему они нужны, вот что случится, если их нарушить.
Что обязательно зафиксировать в политике
Политика работы с ИИ должна включать несколько обязательных пунктов.
- Определение ИИ и чего касается политика. Что вы считаете ИИ? Только большие языковые модели или включаете и узкие ИИ-системы? Какие сервисы попадают под политику? Все ИИ-сервисы или только основные (ChatGPT, Claude, Gemini)? Это нужно для того, чтобы люди понимали, что именно регулируется.
- Разрешённые и запрещённые использования. Какие задачи разрешено делать с помощью ИИ? Какие категорически запрещены? Например: "Разрешено использовать ИИ для генерации черновиков текстов, анализа данных, помощи в рассуждениях. Запрещено: загружать конфиденциальные данные клиентов, персональные данные сотрудников, исходный код production-систем".
- Уровни доступа по должностям или отделам. Кто может что делать? Таблица с должностями и уровнями доступа или со ссылкой на приложение.
- Обязанности при использовании ИИ. Что должен делать сотрудник? Всегда проверять результаты? Не загружать файлы? Обозначать в документе, что текст написан с помощью ИИ? Это нужно для ясности.
- Последствия нарушения. Что случится, если сотрудник нарушит политику? Устное замечание, письменное, дисциплинарное взыскание, увольнение? Это должно быть пропорционально серьёзности нарушения.
- Кто отвечает за контроль. Кто следит, чтобы политика соблюдалась? IT-команда? Отделы? Оба? Как люди могут сообщить о нарушениях?
- Процесс пересмотра политики. Вы не знаете, какой будет ИИ через год. Политика должна быть живым документом. Когда и как она пересматривается? Ежегодно? По запросу?
Типичные ошибки при разработке политики
Есть несколько ошибок, которые компании часто делают при разработке политики работы с ИИ.
Ошибка 1: Политика слишком сложная. 30 страниц, 200 пунктов, язык, который непонятен обычному сотруднику. Люди просто не будут её читать. Хорошая политика — это 3-5 страниц, ясный язык, конкретные примеры. Если нужно, положите большие детали в приложение, а основной текст держите простым.
Ошибка 2: Политика слишком строгая. Полный запрет на использование ИИ или требование одобрения босса для каждого запроса. Люди начнут обходить политику. Лучше дать определённую свободу и контролировать через мониторинг, чем требовать одобрения для всего.
Ошибка 3: Политика не основана на реальности компании. Скопирована из другой компании или написана IT-специалистом, который не консультировался с остальными отделами. Результат: правила не соответствуют реальной работе, и люди их не соблюдают. Хорошая политика должна быть согласована с руководителями отделов.
Ошибка 4: Политика не обновляется. Написана один раз год назад, больше никто её не смотрит. Тем временем появились новые ИИ-сервисы, новые риски, новые возможности. Политика устаревает. Нужно планировать пересмотр минимум один раз в год, лучше два раза.
Ошибка 5: Политика не сообщается правильно. Написана, положена на серверище, и все. Люди не знают, что она есть. Нужно её презентовать: провести встречу, объяснить, почему эти правила нужны, ответить на вопросы, убедиться, что люди поняли.
Создайте механизмы обратной связи между отделами
Когда разные отделы начинают использовать ИИ по-разному, возникают интересные ситуации. Маркетолог находит удачное применение ИИ, которое полезно и финансистам. Продажи сталкиваются с проблемой, которую можно решить тем же способом, что использует HR.
Если в компании нет механизма обратной связи между отделами, каждый решает проблемы самостоятельно, и знания не распространяются. Полезные подходы повторяются независимо в разных местах.
Нужны каналы, через которые отделы могут делиться опытом.
Практические способы организации обратной связи
- Ежемесячные синхронизационные встречи. Проводите встречу, на которую приходят представители каждого отдела, который использует ИИ. 30-40 минут. Каждый рассказывает: что работает хорошо, что не работает, что узнали, какие проблемы столкнулись. Остальные слушают и могут использовать этот опыт.
- Внутренний чат или форум. Создайте канал в Slack или другом мессенджере: "AI-usage" или "ИИ-применение". Люди могут там делиться кейсами, спрашивать советы, предупреждать о проблемах. Что-то вроде внутреннего StackOverflow.
- Документирование best practices. Когда отдел нашёл хороший способ использовать ИИ, попросите его написать краткое описание в вики или документе. Как именно они это делают, что получилось, какие ошибки делали. Это становится шаблоном для других отделов.
- Назначение ИИ-чемпионов. В каждом отделе выберите человека (не обязательно руководителя), который следит за использованием ИИ, экспериментирует, делится опытом. Раз в месяц проводите встречу этих чемпионов, чтобы они обменялись информацией.
- Централизованный реестр ИИ-инструментов и кейсов. Ведите таблицу: какой ИИ-инструмент используется, в каком отделе, для какой задачи, какие результаты, какие проблемы. Это помогает видеть полную картину и находить пересечения между отделами.
Важный момент: обратная связь работает только если люди видят, что их мнение влияет. Если инженер рассказал о проблеме, а ничего не изменилось, он в следующий раз не будет рассказывать. Если маркетолог поделился удачным кейсом, а его никто не использовал, в следующий раз он не будет делиться. Нужно закрывать круг: люди дают информацию, вы анализируете, вы действуете, вы сообщаете результаты.
Как измерять эффективность внедрения ИИ
Через какое-то время (обычно 2-3 месяца после запуска политики) нужно понять, работает ли ваш подход. Работает ли контроль? Используют ли люди ИИ так, как вы планировали? Есть ли утечки данных? Растёт ли производительность?
Нужны метрики. Не обязательно много, но достаточно, чтобы понять общую картину.
Ключевые метрики для измерения
| Метрика | Что измеряет | Где взять данные |
| Процент сотрудников, активно использующих ИИ | Насколько широко ИИ внедрён | Логи OAuth, опросы, анализ корпоративной сети |
| Средняя скорость выполнения задач по отделам | Растёт ли производительность | Системы учёта времени, отчёты руководителей |
| Количество инцидентов с утечкой данных | Работает ли контроль | Логи DLP-системы, отчёты IT-безопасности |
| Процент попыток загрузить запрещённые данные (если блокируются) | Понимают ли люди правила или нарушают ли их | Логи файрволла, мониторинга сети |
| Качество результатов (ошибки, требующие правки) | Помогает ли ИИ или усложняет | Выборочная проверка результатов, опросы |
| Удовлетворённость сотрудников | Воспринимают ли люди политику и инструменты позитивно | Опросы, встречи с отделами |
Не нужно собирать все метрики каждый день. Достаточно сбора раз в месяц. Достаточно выборки данных, не полного анализа.
Создайте простой дашборд (даже в Excel), который показывает эти метрики в динамике. Это поможет вам видеть тренды и быстро реагировать, если что-то идёт не так.
Распространённые ошибки при контроле ИИ
На практике компании делают похожие ошибки при контроле ИИ. Давайте разберём самые распространённые и как их избежать.
Ошибка 1: Контроль без понимания
Компания устанавливает инструменты для контроля (DLP, мониторинг трафика), но люди не понимают, почему это нужно. Они думают, что это слежка. Результат: низкая дисциплина, высокий риск обхода политики.
Решение: объясните людям, почему контроль нужен. Покажите реальные примеры утечек данных в других компаниях. Объясните, чем это опасно именно для вашей компании. Если люди поймут смысл, они будут соблюдать правила добровольно.
Ошибка 2: Слишком жёсткий контроль
Компания требует одобрения босса для каждого использования ИИ или блокирует доступ полностью. Результат: люди используют личные аккаунты, теневое использование ИИ, контроль становится невозможным.
Решение: контроль должен быть достаточным для управления рисками, но не препятствовать работе. Дайте люди определённую свободу в пределах правил.
Ошибка 3: Игнорирование теневого ИИ
Компания запрещает ИИ, но не проверяет соблюдение. Результат: сотрудники используют ИИ скрыто, часто загружают туда конфиденциальные данные, потому что не боятся наказания, а компания ничего об этом не знает.
Решение: если вы решили запретить или ограничить ИИ, нужен мониторинг. Хотя бы периодический. Если мониторинга нет, лучше разрешить и контролировать явно, чем запрещать и получить скрытое использование.
Ошибка 4: Отсутствие обучения
Компания внедрила политику, но не обучила людей. Результат: люди не знают, что разрешено и что запрещено, делают ошибки, появляются утечки.
Решение: проведите обучение. Даже 30-минутная встреча с примерами и Q&A даст больше результата, чем письмо с политикой.
Ошибка 5: Отсутствие гибкости
Политика написана, инструменты установлены, и они никогда не меняются. Компания открывает новое направление, появляются новые риски, появляются новые инструменты — но политика осталась той же. Результат: политика перестаёт быть полезной, люди начинают её игнорировать.
Решение: планируйте пересмотр политики минимум раз в квартал. Собирайте feedback от людей, видите, что работает, что нет, адаптируйте.
FAQ
Использование ИИ в разных отделах слишком рискованно?
Всё зависит от уровня риска, который вы готовы принять, и качества контроля. Если вы внедрите хороший контроль, основанный на понимании данных и процессов, риск будет управляем. Если вы разрешите ИИ везде без контроля, риск высокий. Если вы запретите ИИ, вы лишите себя преимуществ, и люди начнут использовать его скрыто — это тоже рискованно. Оптимальное решение — контролируемое использование с явными правилами.
Кто должен отвечать за риски, связанные с ИИ?
Ответственность распределена. IT-команда отвечает за технический контроль (мониторинг, блокировки). Руководители отделов отвечают за соблюдение политики в своих отделах. Каждый человек отвечает за соблюдение правил в своей работе. Руководство отвечает за то, чтобы политика была понятна и люди были обучены. Если произойдёт инцидент, нужно разобраться, на каком уровне что-то пошло не так, и исправить.
Нужно ли проверять каждый результат работы ИИ человеком?
Нет. Это зависит от критичности результата. Если маркетолог использует ИИ для генерации идей — 100% проверки не нужна. Если финансовый аналитик использует ИИ для прогноза доходов — нужна полная проверка. Если система ИИ классифицирует документы — можно проверять 10-20% выборочно. Определите для каждого процесса, какой процент проверки нужен, исходя из критичности результата.
Чем управление ИИ отличается от контроля рисков в процессах?
Управление ИИ — это более узкое понятие, оно касается только использования ИИ-инструментов. Контроль рисков в процессах — это более широкое понятие, оно касается всех видов рисков в процессе, включая человеческие ошибки, технические сбои, внешние факторы. Управление ИИ — это часть общего контроля рисков в процессах, но не вся система.
Почему сотрудники тайно используют ИИ?
Основные причины: 1) Им запретили использовать ИИ, но они видят, что инструмент полезен, и решают использовать его скрыто. 2) Они не понимают, почему их спрашивают или рассказывают о ИИ — кажется, что это контроль и слежка. 3) Они боятся наказания, если скажут начальнику. 4) Культура компании не поощряет открытость и честность. Решение: объясните, почему нужен контроль, дайте людям определённую свободу в рамках правил, создайте среду, где люди не боятся рассказывать об использовании инструментов.
Ключ к успешному управлению ИИ в компании — это баланс. Баланс между контролем и свободой, между безопасностью и производительностью, между техническими решениями и человеческой ответственностью. Компании, которые найдут этот баланс, получат максимум выгоды от ИИ при минимизации рисков. Те, кто перекосит в одну или другую сторону, либо потеряют возможности, либо столкнутся с проблемами.
Начните с малого. Выберите один отдел, сделайте там пилот. Схема процессов, категоризация данных, политика, обучение. Три-четыре месяца работы. Посмотрите, что получилось. Измерьте результаты. Поправьте, что не сработало. Потом масштабируйте на другие отделы.
Контроль ИИ — это не проблема безопасности, которую нужно решить один раз. Это постоянный процесс адаптации к изменяющимся технологиям, новым рискам и растущему опыту компании. Компании, которые примут этот процесс как часть своей культуры, будут процветать в эпоху искусственного интеллекта.