Мультимодальные модели изменили представление о возможностях искусственного интеллекта. Вместо того чтобы работать только с текстом или только с изображениями, они объединяют несколько типов данных в единую систему понимания. Это не просто техническое усовершенствование — это принципиально иной подход к обработке информации, который приближает машины к человеческому восприятию реальности.
Что такое мультимодальная модель
Мультимодальная модель — это система искусственного интеллекта, способная одновременно обрабатывать и анализировать данные разных типов. Текст, изображения, аудио, видео — все эти форматы она воспринимает не как отдельные фрагменты, а как части единого контекста.
Обычная языковая модель работает исключительно с текстом. Вы пишете запрос — получаете текстовый ответ. Модель компьютерного зрения анализирует изображения, но не понимает текстовых описаний. Мультимодальная система снимает эти ограничения. Вы можете загрузить фотографию интерьера и спросить, как улучшить освещение. Или отправить скриншот кода с ошибкой и получить не только объяснение проблемы, но и готовое решение с учетом визуального контекста.
Ключевое отличие мультимодальных моделей от простого объединения нескольких специализированных систем — в способности устанавливать связи между разными типами данных. Модель не просто видит картинку и читает текст по отдельности. Она понимает, как изображение соотносится с текстовым описанием, какие объекты на фото соответствуют словам в вопросе, какой контекст необходим для правильной интерпретации.
Человек воспринимает мир мультимодально. Мы видим лицо собеседника, слышим интонацию, читаем текст сообщения — и всё это формирует единое понимание ситуации. Мультимодальные модели движутся в том же направлении.
Почему это важно для практического применения
Большинство бизнес-задач по своей природе мультимодальны. Клиент присылает фотографию бракованного товара и описание проблемы. Врач анализирует снимок и историю болезни пациента. Дизайнер создает макет на основе брифа и референсов. Во всех этих случаях разделение на отдельные типы данных искусственно и неэффективно.
До появления мультимодальных систем приходилось выстраивать сложные цепочки обработки. Сначала одна модель распознавала объекты на изображении, затем другая генерировала текстовое описание, третья анализировала текст и формировала ответ. Каждый переход между системами терял часть контекста. Мультимодальные модели решают задачу целиком, сохраняя все связи между элементами.
Как устроены мультимодальные модели
Архитектура мультимодальной модели напоминает работу человеческого мозга, где разные отделы обрабатывают зрительную, слуховую, текстовую информацию, но все они соединены и обмениваются сигналами. В техническом смысле это означает, что модель состоит из нескольких компонентов, каждый из которых специализируется на своем типе данных, но все они работают в едином пространстве представлений.
Энкодеры и общее пространство признаков
Первый этап обработки — преобразование разнородных данных в единый формат, который модель может анализировать. Для этого используются энкодеры — специализированные нейронные сети, которые превращают изображения, текст или аудио в векторные представления.
Текстовый энкодер берет последовательность слов и преобразует ее в набор чисел, которые отражают смысл текста. Визуальный энкодер делает то же самое с изображением, разбивая его на патчи и извлекая признаки. Аудио энкодер работает со звуковыми волнами. Все эти векторы попадают в общее пространство признаков — абстрактную область, где текстовое описание кошки и фотография кошки оказываются близко друг к другу.
Это общее пространство — основа мультимодальности. Именно здесь модель понимает, что слово "стол" и изображение стола связаны, что описание эмоции в тексте соответствует выражению лица на фото. Без такого пространства модель работала бы как набор изолированных систем.
Механизм внимания между модальностями
После того как разные типы данных преобразованы в векторы, модель должна научиться связывать их между собой. Для этого используется механизм кросс-внимания. Он позволяет модели обращать внимание на определенные части изображения при анализе текстового запроса или учитывать контекст текста при интерпретации визуальных элементов.
Представьте запрос: "Какого цвета машина на заднем плане?". Модель должна не просто распознать все объекты на фото, а найти конкретную машину, понять, что она находится на заднем плане, и определить ее цвет. Механизм внимания выделяет релевантную область изображения и связывает ее с соответствующей частью текстового запроса.
Этот процесс работает в обе стороны. Модель может генерировать текстовое описание изображения, учитывая, какие объекты на нем важны. Или создавать изображение на основе текста, понимая, какие визуальные элементы должны соответствовать словам.
Обучение на парных данных
Мультимодальные модели учатся на огромных датасетах, где каждый элемент содержит несколько типов данных одновременно. Например, фотография и ее текстовое описание. Или видео с субтитрами. Модель анализирует миллионы таких пар и учится находить соответствия.
В процессе обучения модель решает несколько задач одновременно:
- сопоставление изображения и текста — определить, соответствует ли описание картинке
- генерация описания по изображению — создать текст, который точно передает содержание фото
- поиск изображения по текстовому запросу — найти картинку, которая лучше всего соответствует описанию
- ответы на вопросы по визуальному контексту — понять, о чем спрашивают, и дать точный ответ на основе изображения
Такой подход позволяет модели не просто запоминать соответствия, а понимать глубинные связи между разными типами информации.
Мультимодальная модель не видит границы между текстом и изображением. Для нее это разные способы представления одной и той же реальности.
Подходы к созданию мультимодальных нейросетей
Существует несколько архитектурных стратегий, каждая из которых имеет свои преимущества и ограничения. Выбор подхода зависит от задачи, доступных вычислительных ресурсов и требований к точности.
Tool-augmented LLM
Этот подход основан на том, что базовая языковая модель остается текстовой, но получает доступ к внешним инструментам для работы с другими модальностями. Модель не обрабатывает изображения напрямую, а вызывает специализированную систему компьютерного зрения, получает от нее текстовое описание и использует его для формирования ответа.
Преимущество этого метода — гибкость. Вы можете подключать разные инструменты в зависимости от задачи. Для анализа изображений — одну модель, для распознавания речи — другую, для работы с видео — третью. Языковая модель выступает в роли координатора, который вызывает нужные инструменты и объединяет результаты.
Недостаток — потеря части информации при переводе из одной модальности в другую. Когда модель компьютерного зрения превращает изображение в текстовое описание, она неизбежно упрощает визуальную информацию. Мелкие детали, пространственные отношения, цветовые нюансы могут быть утеряны. Языковая модель работает уже не с исходным изображением, а с его интерпретацией.
Кроме того, такая система медленнее. Каждый вызов внешнего инструмента добавляет задержку, что критично для приложений реального времени.
End-to-End multimodal LLM
Нативная мультимодальная архитектура предполагает, что модель изначально обучена работать с разными типами данных. Визуальный энкодер встроен в саму модель, и она обрабатывает изображения и текст в едином процессе без промежуточных преобразований.
Такой подход дает более глубокое понимание визуального контекста. Модель видит изображение целиком, анализирует его на всех уровнях — от низкоуровневых признаков вроде линий и текстур до высокоуровневых концепций вроде объектов и сцен. Она может отвечать на сложные вопросы, требующие понимания пространственных отношений, контекста, деталей, которые сложно описать текстом.
Примеры таких моделей — GPT-4o, Gemini, Claude. Они могут анализировать диаграммы, читать текст на фотографиях, понимать мемы, объяснять, почему изображение смешное или грустное.
Сложность этого подхода — в обучении. Требуются огромные датасеты и вычислительные мощности. Модель должна одновременно учиться понимать визуальные признаки и связывать их с языковыми концепциями. Это дорого и технически сложно.
Modality-bridging with pretrained models
Промежуточный вариант — использование предобученных моделей с добавлением моста между модальностями. Берется готовая языковая модель, готовый визуальный энкодер, и между ними обучается относительно небольшой адаптер, который переводит визуальные представления в формат, понятный языковой модели.
Этот подход экономит ресурсы. Не нужно обучать всю модель с нуля. Основные компоненты уже натренированы на своих задачах и работают эффективно. Адаптер учится только связывать их между собой.
Минус — адаптер может стать узким местом. Если связь между модальностями недостаточно сильная, модель будет хуже понимать сложные визуально-текстовые задачи. Это компромисс между качеством и эффективностью.
Типы данных, которые обрабатывают мультимодальные ИИ
Мультимодальность не ограничивается текстом и изображениями. Современные модели работают с широким спектром форматов, и список продолжает расти.
Текст
Базовая модальность для большинства систем. Текст несет явную семантическую информацию, его легко токенизировать и обрабатывать. Мультимодальные модели используют текст не только как входные данные, но и как способ интеграции других модальностей. Визуальная информация часто превращается в текстовые описания, аудио транскрибируется в текст.
Изображения
Статичные визуальные данные. Модель анализирует композицию, объекты, цвета, текстуры, пространственные отношения. Может работать с фотографиями, скриншотами, диаграммами, графиками, рисунками. Некоторые модели читают текст на изображениях, что превращает фото документа в структурированные данные.
Видео
Последовательность кадров с временной динамикой. Модель анализирует не только содержание отдельных кадров, но и изменения во времени — движение объектов, смену сцен, действия персонажей. Это требует больше вычислительных ресурсов, чем работа с изображениями, но дает понимание процессов и событий.
Аудио
Звуковые данные, включая речь, музыку, окружающие звуки. Модель может транскрибировать речь в текст, определять эмоциональную окраску голоса, распознавать музыкальные жанры, идентифицировать источники звука. В сочетании с видео это дает полное понимание аудиовизуального контента.
Структурированные данные
Таблицы, графы, временные ряды. Мультимодальные модели могут анализировать датасеты, находить закономерности, отвечать на вопросы по данным, генерировать визуализации. Это расширяет применимость ИИ в аналитике и науке.
3D-данные
Трехмерные модели, облака точек, данные с сенсоров глубины. Используются в робототехнике, архитектуре, медицине. Модель может понимать пространственную структуру объектов, планировать движения робота в физическом пространстве, анализировать 3D-сканы.
Комбинация этих модальностей открывает новые возможности. Модель может анализировать видео с аудио и текстовыми субтитрами одновременно, учитывая все три источника информации. Или работать с медицинскими данными, где есть снимки, текстовые заключения врачей, временные ряды показателей здоровья.
Ведущие мультимодальные модели
Рынок мультимодальных систем развивается быстро. Каждые несколько месяцев появляются новые модели с улучшенными характеристиками. Рассмотрим ключевые решения, которые определяют текущее состояние технологии.
GPT-4o
Омни-модель от OpenAI, где буква "о" означает "omni" — всё сразу. Это нативная мультимодальная система, обученная одновременно на тексте, изображениях и аудио. Особенность GPT-4o — скорость и качество работы с визуальным контекстом.
Модель понимает сложные диаграммы, читает рукописный текст, анализирует интерфейсы, объясняет визуальные шутки. Она может вести диалог на основе изображений, задавать уточняющие вопросы, указывать на конкретные области картинки. В аудио модальности GPT-4o распознает эмоции, интонации, фоновые звуки.
Применение — от автоматизации клиентской поддержки до образовательных платформ, где студенты загружают фото задач и получают пошаговые объяснения.
Gemini
Мультимодальная модель от Google, изначально спроектированная для работы с разными типами данных. Gemini существует в нескольких версиях, от компактной до максимальной, что позволяет выбирать баланс между производительностью и качеством.
Сильная сторона Gemini — интеграция с экосистемой Google. Модель может работать с документами, таблицами, презентациями, анализировать данные из YouTube, Google Maps, других сервисов. Это делает ее удобной для корпоративных задач, где нужна связь с существующими инструментами.
Gemini хорошо справляется с математическими задачами на изображениях, анализом графиков, извлечением структурированной информации из визуальных документов.
Claude
Мультимодальная модель от Anthropic с акцентом на безопасность и точность. Claude анализирует изображения, документы, скриншоты, но делает это консервативно — не генерирует контент, который может быть неоднозначным или вредным.
Модель показывает отличные результаты в работе с текстом на изображениях, анализе технической документации, объяснении кода по скриншотам. Часто используется в задачах, где критична точность и надежность ответа.
GigaChat
Российская мультимодальная модель от Сбера. Поддерживает русский язык на нативном уровне, что важно для работы с локальным контентом. Может генерировать и анализировать изображения, работать с текстом, понимать контекст диалога.
GigaChat интегрируется с российскими сервисами и платформами, что делает его практичным выбором для компаний, работающих внутри страны. Модель учитывает культурный контекст, понимает отсылки, специфичные для русскоязычной аудитории.
Kandinsky
Генеративная модель, специализирующаяся на создании изображений по текстовым описаниям. Разработана командой Sber AI. Kandinsky не просто рисует картинки, а понимает сложные текстовые запросы с несколькими объектами, стилистическими указаниями, композиционными требованиями.
Модель работает с русскоязычными промптами без потери качества, что упрощает ее использование для создания контента, маркетинговых материалов, иллюстраций.
Все эти модели продолжают развиваться. Новые версии выходят регулярно, улучшая точность, скорость, расширяя набор поддерживаемых модальностей. Выбор конкретной модели зависит от задачи, языка, требований к безопасности и доступности API.
Где применяют мультимодальный ИИ
Мультимодальные модели перестали быть экспериментальной технологией. Они решают реальные бизнес-задачи в разных отраслях, часто заменяя целые цепочки специализированных систем одним универсальным решением.
Медицина
Диагностика заболеваний требует анализа разнородных данных. Врач смотрит на снимки, читает результаты анализов, изучает анамнез пациента. Мультимодальные модели объединяют эти источники информации в единую систему поддержки принятия решений.
Модель анализирует рентгеновские снимки и находит аномалии, затем сопоставляет их с текстовым описанием симптомов и историей болезни. Она может указать на области, требующие внимания, предложить список возможных диагнозов с обоснованием, сравнить текущие снимки с предыдущими и отметить динамику изменений.
В онкологии мультимодальные системы анализируют гистологические изображения тканей вместе с генетическими данными пациента и результатами лабораторных тестов. Это помогает подобрать персонализированную терапию с учетом всех факторов.
В офтальмологии модели работают со снимками сетчатки и могут выявлять диабетическую ретинопатию, глаукому, возрастную макулярную дегенерацию на ранних стадиях. Точность таких систем уже сопоставима с экспертными заключениями врачей, а в некоторых задачах превосходит их.
Мультимодальный анализ медицинских данных не заменяет врача, но дает ему инструмент, который обрабатывает информацию быстрее и замечает паттерны, которые человек может упустить.
Клиентский сервис
Большая часть обращений в службу поддержки содержит не только текст, но и визуальный контекст. Клиент присылает фото сломанного устройства, скриншот ошибки, видео проблемы. Мультимодальные модели обрабатывают такие запросы без участия человека.
Модель видит на фотографии конкретную модель техники, определяет характер повреждения, проверяет гарантийный статус в базе данных и формирует ответ с инструкциями по решению проблемы или условиями ремонта. Если проблему можно устранить самостоятельно, система генерирует пошаговую инструкцию с учетом того, что именно сломалось.
В банковской сфере клиенты присылают фото документов для верификации. Мультимодальная модель читает паспортные данные, проверяет их корректность, сопоставляет с информацией в анкете, выявляет несоответствия. Это ускоряет процесс идентификации и снижает количество мошеннических заявок.
Чат-боты с мультимодальными возможностями понимают контекст диалога даже когда клиент переключается между текстом и изображениями. Можно спросить текстом о товаре, прислать фото похожего предмета и уточнить отличия, получить рекомендации на основе визуальных предпочтений.
Образование
Студенты учатся не только по тексту, но и по схемам, графикам, видео, интерактивным материалам. Мультимодальные системы адаптируют образовательный процесс под разные способы восприятия информации.
Модель может объяснить математическую задачу, если студент пришлет фото учебника или свои рукописные вычисления. Она укажет на ошибку в решении, объяснит, почему подход неверный, предложит правильный метод. Не просто даст ответ, а проведет через логику решения.
В изучении языков мультимодальные системы анализируют произношение по аудио, оценивают письменные упражнения, работают с видео материалами, где важна визуальная составляющая. Студент может записать свою речь, и модель укажет на ошибки в произношении, интонации, грамматике.
Для людей с ограниченными возможностями мультимодальные технологии открывают новые способы обучения. Визуальная информация превращается в текстовые описания для слабовидящих. Аудио контент транскрибируется для людей с нарушениями слуха. Сложные тексты упрощаются и дополняются иллюстрациями.
Платформы онлайн-образования используют мультимодальные модели для автоматической проверки заданий, где требуется анализ не только текста ответа, но и приложенных схем, графиков, кода, визуальных проектов.
E-commerce
Поиск товаров перестал ограничиваться текстовыми запросами. Покупатель может сфотографировать понравившуюся вещь на улице или у знакомого и найти похожие товары в магазине. Мультимодальная модель анализирует изображение, определяет категорию, стиль, цвет, материал и подбирает соответствующие позиции из каталога.
Виртуальные примерочные используют комбинацию компьютерного зрения и генеративных моделей. Клиент загружает свое фото, выбирает одежду, и система показывает, как вещь будет на нем сидеть. Это снижает количество возвратов и повышает удовлетворенность покупками.
Визуальные рекомендательные системы анализируют историю просмотров и покупок, учитывая не только категории товаров, но и визуальные предпочтения. Если клиент часто выбирает вещи определенного цвета или стиля, модель будет показывать похожие варианты, даже если они относятся к разным категориям.
Генерация описаний товаров автоматизируется с помощью мультимодальных систем. Модель получает фотографии продукта и создает текст с характеристиками, преимуществами, вариантами использования. Для маркетплейсов с десятками тысяч позиций это экономит огромное количество времени.
Модерация контента в отзывах и комментариях учитывает не только текст, но и приложенные фото. Модель определяет, соответствует ли изображение товару, нет ли на нем запрещенного контента, действительно ли это фото реального использования продукта или взято из интернета.
Аналитика
Бизнес-аналитика работает с данными в разных форматах. Таблицы с метриками, графики трендов, текстовые отчеты, презентации. Мультимодальные модели анализируют всё это комплексно.
Модель может взять финансовый отчет в виде PDF с графиками и таблицами, извлечь ключевые показатели, сравнить их с предыдущими периодами, выявить аномалии и сформировать текстовое резюме с выводами. Аналитику не нужно вручную собирать данные из разных источников.
В маркетинге мультимодальные системы анализируют эффективность визуального контента. Модель оценивает, какие изображения в рекламе привлекают больше внимания, какие цветовые схемы работают лучше, как композиция влияет на вовлеченность. Это данные, которые сложно получить через традиционную аналитику.
Мониторинг социальных сетей включает анализ постов с изображениями и видео. Модель определяет тональность не только текста, но и визуального ряда. Фотография может быть негативной, даже если подпись нейтральная. Или наоборот, текст критический, но изображение показывает реальное использование продукта в положительном контексте.
Анализ конкурентов автоматизируется через мониторинг их сайтов, рекламных материалов, упаковки продуктов. Модель отслеживает изменения в визуальной айдентике, новые маркетинговые подходы, тренды в оформлении.
- автоматическое создание дашбордов с визуализацией данных из разных источников
- генерация отчетов с графиками и текстовыми выводами
- ответы на вопросы по данным в естественном языке
- прогнозирование трендов на основе исторических данных
- выявление корреляций между визуальными и числовыми метриками
Плюсы и минусы мультимодального ИИ
Любая технология имеет ограничения. Мультимодальные модели решают множество задач, но не все проблемы исчезают автоматически с их появлением.
Основные преимущества
Единый интерфейс для разных типов данных упрощает архитектуру систем. Вместо того чтобы интегрировать несколько специализированных моделей, можно использовать одну мультимодальную. Это снижает сложность разработки, уменьшает количество точек отказа, упрощает поддержку.
Контекстное понимание повышает качество ответов. Модель видит полную картину, а не фрагменты информации. Она понимает, как текст связан с изображением, какие визуальные элементы важны для ответа на вопрос, какой контекст необходим для правильной интерпретации данных.
Гибкость в применении расширяет спектр задач, которые можно автоматизировать. Мультимодальная модель работает там, где специализированные системы бессильны. Анализ документов со сложной структурой, где текст перемежается таблицами и графиками. Обработка запросов клиентов, которые содержат фото и описание проблемы. Создание контента, где нужна связь между визуальной и текстовой частью.
Естественность взаимодействия приближает общение с ИИ к человеческому. Вы можете показать модели картинку и спросить о ней, как спросили бы у коллеги. Не нужно разбивать запрос на отдельные части, формулировать специальным образом, использовать промежуточные инструменты.
Перенос знаний между модальностями позволяет модели использовать опыт из одной области в другой. Если модель научилась распознавать эмоции в тексте, она может применить это понимание к анализу выражений лиц на фотографиях. Знания о физическом мире, полученные из текстовых описаний, помогают интерпретировать видео.
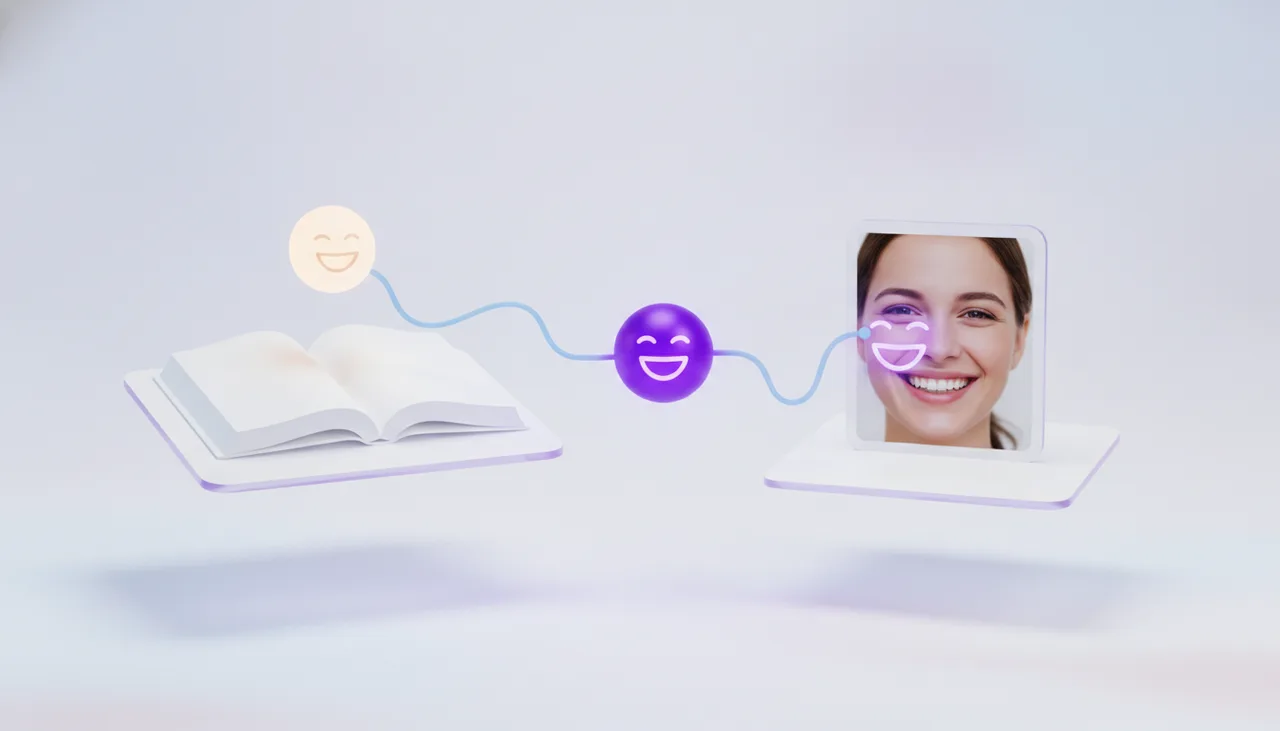
Мультимодальная модель не просто суммирует возможности разных систем. Она создает новый уровень понимания, который возникает из взаимодействия модальностей.
Ограничения и проблемы
Вычислительная сложность остается главным барьером для широкого применения. Обработка изображений и видео требует значительно больше ресурсов, чем работа с текстом. Модель должна анализировать каждый кадр, извлекать признаки, связывать их с текстовым контекстом. Это медленно и дорого.
Для задач реального времени, таких как видео конференции с ИИ-ассистентом или робототехника, задержки критичны. Мультимодальные модели пока не всегда справляются с требованиями низкой латентности.
Качество работы зависит от модальности. Модель может отлично понимать текст, но хуже справляться с анализом изображений. Или наоборот, хорошо распознавать объекты на фото, но недостаточно точно связывать их с текстовыми описаниями. Это связано с тем, что разные модальности требуют разного объема данных для обучения, и не всегда удается достичь баланса.
Проблемы выравнивания между модальностями возникают, когда модель неправильно связывает визуальные и текстовые элементы. Например, на изображении несколько объектов, и модель должна понять, к какому именно относится вопрос. Ошибки в выравнивании приводят к неверным ответам, даже если каждая модальность обработана корректно.
Bias и галлюцинации усиливаются в мультимодальных системах. Модель может видеть на изображении то, чего там нет, особенно если визуальный контекст неоднозначный. Или интерпретировать картинку через призму стереотипов, присутствующих в обучающих данных. Например, ассоциировать определенные профессии с конкретным полом или расой.
Сложность отладки возрастает, когда модель работает с несколькими типами данных одновременно. Если ответ неверный, сложно определить, в какой модальности произошла ошибка. Может быть, модель неправильно распознала объект на изображении. А может, верно распознала, но неверно связала с текстом. Или ошибка в языковой части, которая неправильно интерпретировала запрос.
Требования к данным для обучения огромны. Нужны датасеты, где каждый элемент содержит несколько модальностей с правильными аннотациями. Создание таких датасетов дорого и трудоемко. Для узкоспециализированных областей, таких как медицина или промышленность, подходящих данных может просто не существовать в достаточном объеме.
Безопасность и конфиденциальность усложняются, когда модель обрабатывает визуальные данные. Изображения могут содержать личную информацию, которую сложно автоматически обнаружить и удалить. Лица людей, номера автомобилей, адреса, документы. Мультимодальная модель видит всё это, и необходимо обеспечить, чтобы данные не утекли и не использовались неправомерно.
Ограниченная интерпретируемость мешает понять, почему модель приняла конкретное решение. В текстовых моделях можно проанализировать внимание к определенным словам. В мультимодальных системах связей намного больше, и отследить логику модели становится практически невозможно. Это критично для регулируемых отраслей, где требуется объяснимость решений ИИ.
- высокая стоимость инференса для задач с видео
- необходимость специализированного оборудования с GPU
- сложность развертывания на edge-устройствах
- ограниченная поддержка некоторых модальностей в open-source моделях
- проблемы с обработкой данных низкого качества
Эти ограничения не означают, что мультимодальные модели бесполезны. Они показывают, где технология находится сейчас и какие проблемы еще предстоит решить. Для многих задач преимущества перевешивают недостатки, но важно понимать границы применимости.
Часто задаваемые вопросы
Чем мультимодальная модель отличается от обычной языковой модели?
Обычная языковая модель работает исключительно с текстом. Она анализирует последовательности слов, находит закономерности, генерирует новые тексты. Если вы дадите ей изображение, она не сможет его обработать. Максимум, что она может сделать — это работать с текстовым описанием изображения, которое подготовил человек или другая система.
Мультимодальная модель обрабатывает изображения, видео и аудио напрямую, без промежуточных преобразований. Она видит пиксели, анализирует их, извлекает визуальную информацию и связывает ее с текстовым контекстом. Это означает, что модель может замечать детали, которые человек пропустил бы при описании, и отвечать на вопросы, требующие глубокого анализа визуального контента.
Кроме того, мультимодальные модели лучше понимают естественные запросы. Когда вы общаетесь с человеком, вы часто комбинируете слова, жесты, указываете на объекты. Мультимодальная модель может работать с такими комбинированными запросами — вы спрашиваете текстом, показываете картинку, и модель понимает, что вопрос относится именно к этому изображению.
Какие типы данных может обрабатывать мультимодальный ИИ?
Спектр модальностей, с которыми работают современные мультимодальные модели, расширяется. Базовые модели поддерживают текст и изображения. Более продвинутые добавляют видео и аудио. Передовые системы работают со структурированными данными, 3D-моделями, временными рядами.
Текст — самая универсальная модальность. Все основные мультимодальные модели работают с текстом на нескольких языках, хотя качество может отличаться.
Изображения обрабатываются всеми современными мультимодальными системами. Модели могут распознавать объекты, читать текст на фото, анализировать композицию, определять эмоции на лицах.
Видео поддерживается растущим числом моделей. Системы анализируют последовательность кадров, понимают движение, отслеживают объекты, анализируют действия людей.
Аудио работает в основном через транскрибирование в текст, хотя некоторые модели начинают работать с аудио напрямую, сохраняя информацию о тональности и интонации.
Структурированные данные в виде таблиц, графов, диаграмм анализируются моделями, которые могут извлекать информацию и отвечать на вопросы по данным.
Ограничение здесь в том, что не все модальности поддерживаются одинаково хорошо. Если вам нужна работа с редкой или специализированной модальностью, может потребоваться кастомизация модели или разработка собственного решения.
Какая мультимодальная модель лучше всего работает в 2026 году?
Ответ зависит от конкретной задачи. Нет универсально лучшей модели, есть модели, лучше подходящие для разных целей.
Для анализа медицинских изображений специализированные модели, обученные на медицинских датасетах, работают точнее, чем универсальные системы. Для работы с русскоязычным контентом GigaChat или русские версии других моделей дают лучшие результаты, чем модели, обученные в основном на английском.
GPT-4o хорошо справляется с анализом сложных изображений, включая диаграммы и таблицы. Gemini интегрируется с экосистемой Google, что полезно для корпоративных задач. Claude показывает хорошие результаты в задачах, требующих точности и безопасности.
Для генерации изображений Kandinsky и DALL-E показывают разные сильные стороны. Kandinsky лучше работает с русскоязычными описаниями, DALL-E обладает большей художественной выразительностью.
Стоит учитывать и практические аспекты. Стоимость API, доступность в вашем регионе, требования к приватности данных, возможность развертывания локально — всё это влияет на выбор модели не меньше, чем ее качество.
Рекомендация — попробуйте несколько моделей на вашей конкретной задаче и сравните результаты. Погрузитесь в документацию, поэкспериментируйте с различными настройками и подсказками. Часто разница в качестве между лучшей и второй по рейтингу моделью для вашего случая оказывается минимальной, а различия в удобстве использования и цене очень существенными.
Как начать работу с мультимодальной моделью
Теория полезна, но настоящее понимание приходит через практику. Если вы хотите самостоятельно испробовать мультимодальные модели, начните с простого.
Первые шаги для неразработчиков
Наиболее доступный способ — использовать веб-интерфейсы моделей. OpenAI предоставляет ChatGPT с возможностью загружать изображения. Google предлагает Gemini в браузере. Яндекс Лаборатория тестирует российские решения. Просто загрузите изображение и задайте вопрос.
Начните с простых задач. Спросите модель, что находится на картинке. Загрузите фото документа и попросите прочитать текст. Отправьте скриншот ошибки и попросите объяснить, в чем проблема. Это помогает понять, что умеет делать модель и где она ошибается.
Постепенно усложняйте задачи. Загружайте несколько изображений и просите модель их сравнить. Задавайте уточняющие вопросы. Указывайте на конкретные части изображения и просите проанализировать их детальнее.
Экспериментируйте с разными формулировками вопросов. Иногда небольшое изменение в формулировке кардинально меняет качество ответа. Модель лучше понимает конкретные, детальные вопросы, чем размытые.
Для разработчиков
Если вы разработчик, начните с API. Большинство мультимодальных моделей предоставляют REST API или SDK для популярных языков программирования.
Установите SDK вашей выбранной модели. Создайте простой скрипт, который загружает изображение и получает описание. Постепенно усложняйте функционал — добавляйте обработку результатов, интеграцию с вашим приложением, обработку ошибок.
Обратите внимание на стоимость инференса. Мультимодальные запросы с изображениями дороже, чем текстовые. Если вы планируете большой объем запросов, оптимизация станет важной. Сжимайте изображения перед отправкой, кешируйте результаты, группируйте запросы.
Изучите возможности токенизации изображений в конкретной модели. Разные модели по-разному считают стоимость изображений. Понимание этого поможет писать более эффективный код.
Рассмотрите использование локальных моделей, если требуется обработать чувствительные данные. Open-source модели типа LLaVA или других можно развернуть на своем оборудовании без отправки данных третьим сторонам.
Будущее мультимодальных систем
Технология развивается быстро. Каждые несколько месяцев появляются улучшения, которые меняют возможности и применимость мультимодальных моделей.
На горизонте — более глубокая интеграция модальностей. Сейчас система обрабатывает текст, изображение и видео, но они все еще относительно независимы. В будущем модели будут еще лучше понимать связи между ними. Видео с аудиодорожкой и субтитрами будут анализироваться как единое целое, где каждый элемент дополняет другие.
Персонализированные мультимодальные модели позволят компаниям обучать системы на своих данных, сохраняя специфику их бизнеса. Модель, обученная на медицинских данных конкретной клиники, будет диагностировать точнее, чем универсальная система, благодаря пониманию локальных особенностей.
Нейросети будут эффективнее. Текущие модели требуют огромных вычислительных ресурсов. Исследования в области дистилляции моделей, количественной оптимизации и архитектурных улучшений приведут к созданию систем, которые работают на менее мощном оборудовании без значительной потери качества.
Появятся истинно живые модальности. Сейчас мультимодальность в основном означает комбинацию текста с другими форматами. В будущем системы будут генерировать не отдельно текст, не отдельно изображения, а создавать логически связанный мультимодальный контент, где текст, картинки и видео работают как единое произведение.
Объяснимость станет приоритетом. Регуляторы и компании требуют понимать, почему ИИ принял то или иное решение. Методы интерпретации мультимодальных моделей будут совершенствоваться, позволяя глубже видеть внутренние процессы.
Интеграция с физическим миром расширится. Робототехника, автономные системы, дроны будут использовать мультимодальные модели для понимания окружающей среды. Это потребует новых архитектур, способных работать с потоком данных реального времени и принимать решения с минимальной задержкой.
Комплексные рассуждения улучшатся. Сейчас модели анализируют данные, но многоступенчатые логические цепочки, требующие комбинирования информации из разных модальностей, остаются сложным. Будущие системы будут лучше справляться с такими задачами, более последовательно решая сложные проблемы.
Мультимодальные модели — это не просто очередной улучшение в области ИИ. Это переход к системам, которые воспринимают мир так же многогранно, как человек.
Практические советы для внедрения
Если вы планируете использовать мультимодальные модели в своем проекте, важно не просто выбрать модель, но правильно подготовиться к внедрению.
Определите точные требования. Какие типы данных вам нужно обрабатывать? С какой частотой? Какие допустимые задержки? Какой уровень точности критичен? Ответы на эти вопросы определят выбор архитектуры и модели.
Подготовьте данные. Если вы обучаете модель на своих данных, убедитесь, что датасет качественный, хорошо аннотирован и сбалансирован. Включите примеры граничных случаев, которые модель должна корректно обрабатывать.
Тестируйте комплексно. Проверяйте не только точность на тестовом наборе, но и поведение на реальных данных. Модель может работать хорошо в идеальных условиях и ошибаться на слегка некачественных фото, размытых видео, неясных аудиозаписях.
Планируйте обновления. Мультимодальные модели быстро развиваются. Регулярно проверяйте новые версии, сравнивайте их качество с используемой, планируйте миграцию, если новая версия дает значимые улучшения.
Мониторьте результаты. После внедрения отслеживайте, как модель работает на реальных данных. Собирайте примеры ошибок, анализируйте причины, постоянно улучшайте систему.
Обеспечьте безопасность. Мультимодальные системы обрабатывают потенциально чувствительные данные. Убедитесь, что данные защищены, что модель не пропускает информацию, которую не должна видеть, что есть контроль доступа и логирование.
Правильное внедрение мультимодальных моделей требует времени и внимания к деталям, но окупается через повышение качества услуг, снижение затрат на ручную обработку данных и открытие новых возможностей для бизнеса.
Мультимодальные модели переходят из экспериментальной стадии в производство. Компании, которые сейчас научатся их эффективно использовать, получат конкурентное преимущество. Технология не простая, требует глубокого понимания того, как она работает, и ее ограничений. Но для задач, требующих анализа разнородных данных, это уже не будущее, а настоящее.